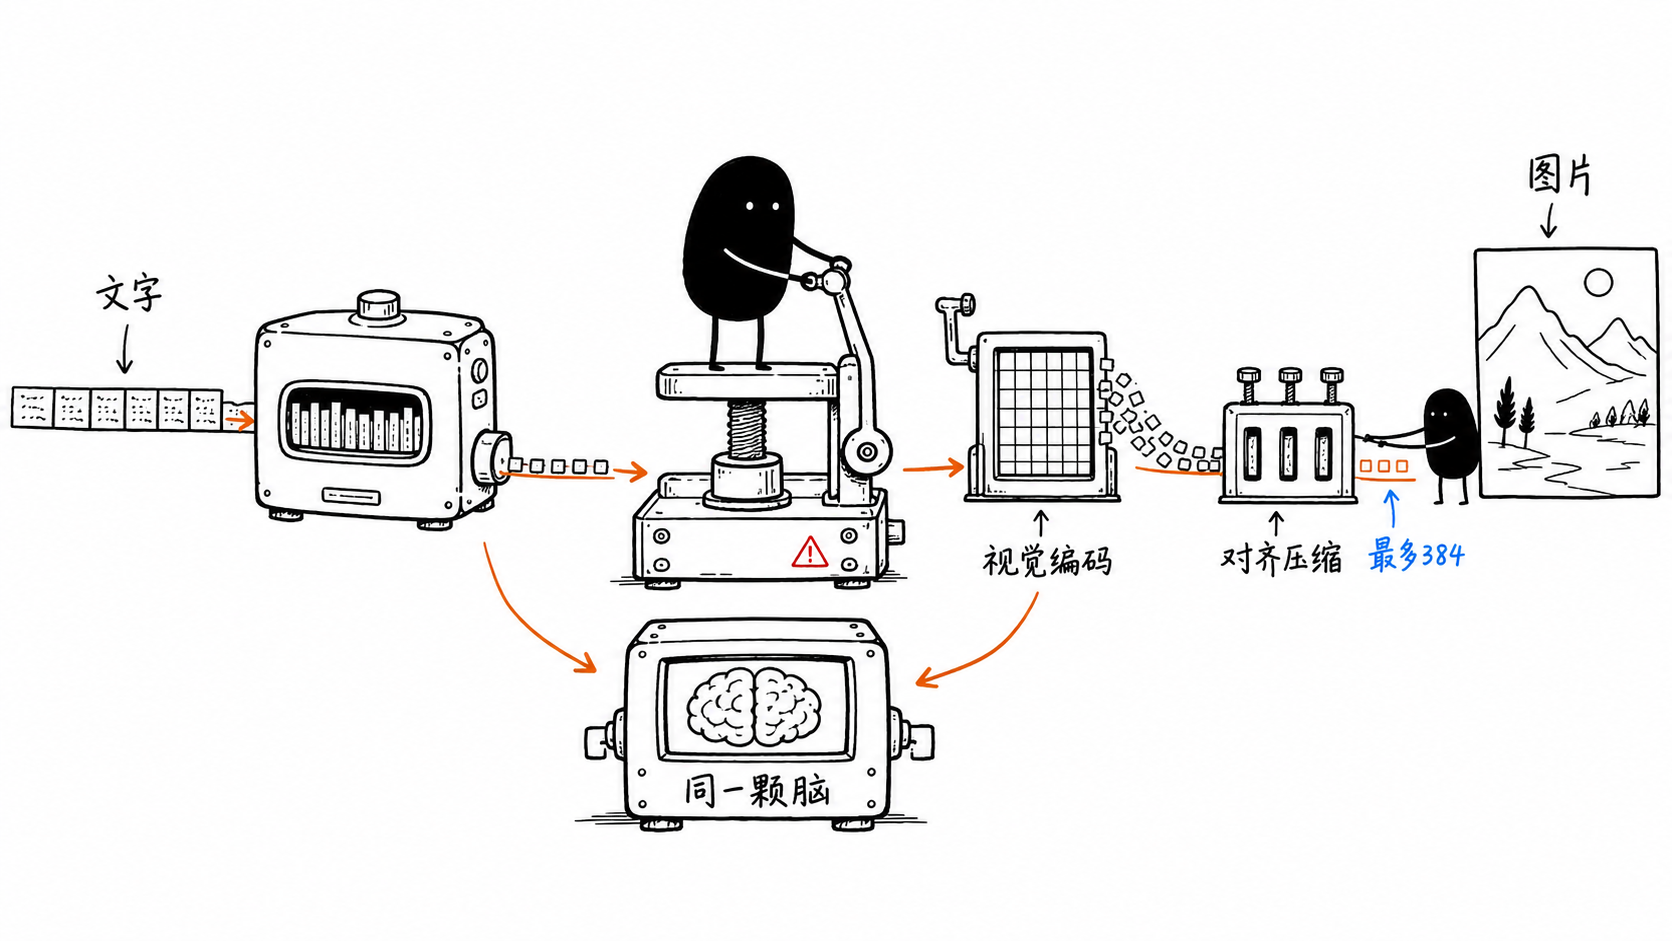
如果只看 API,Vision-Exp 很像是在 V4 Flash 后面加了一个“支持图片”的开关。实际情况复杂一点:文字仍然走原来的语言路径,图片则需要先经过视觉编码和对齐,再压缩成语言主干能够处理的 token。
这件事会直接影响三个问题:模型到底看到了多少图像细节、一次请求要花多少 token,以及图片有没有真的穿过客户端到达 API。后两个问题,在公开使用记录里出现得比模型能力本身更频繁。
先说结论
纯文本推理、代码补全和普通 Agent 任务,V4 Flash 仍然是更直接的选择。Vision-Exp 的价值在于它可以把截图、图表和页面状态带进同一条推理链,而不是让另一个 OCR 服务先生成一段文字摘要。
结构差在哪里
两者的语言部分都采用 V4 Flash 的稀疏 MoE 思路。公开配置里,语言主干为 43 层,包含 256 个路由专家和 1 个共享专家,每个 token 激活少量专家参与计算。V4 Flash 官方披露总参数约 285B、每个 token 激活约 13B。
Vision-Exp 增加了一套 32 层、1024 隐藏维、16 个注意力头的视觉编码器。图片按 14×14 patch 处理,经过编码与对齐后,最多形成 384 个视觉 token,再交给语言主干继续推理。
| 项目 | V4 Flash | V4 Flash Vision-Exp |
|---|---|---|
| 原生输入 | 文字 | 文字、图片 |
| 公开总参数 | 约 285B | checkpoint 标示约 305B |
| 视觉模块 | 无 | 32 层、1024 维、16 头 |
| 单图视觉预算 | 不适用 | 最多 384 个视觉 token |
| 更适合 | 纯文本、代码、FIM 补全 | 截图、图表、图文混合 Agent |
384 个视觉 token 是一个很实际的限制。模型面对的不是无限分辨率画布,而是一份被压缩后的视觉表示。整张网页、密集表格或合同扫描件里,小字号和角落信息很容易在缩放过程中丢失。需要读细节时,裁剪和分块通常比重复发送同一张大图有效。
公开实测怎么说
我们核对了 12 条公开的一手记录,包括个人实测、社区小型基准和可复现的 GitHub 实验。它们不能用来计算“满意率”,但很适合观察标准 benchmark 覆盖不到的部分:长任务、客户端适配、图片拆帧和缓存。
工具调用稳定,但规划并不快
一名用户用早期 Flash 处理大规模代码修改,记录了至少 100 次工具调用且没有调用错误;同一记录也提到,正式执行前的思考有时会持续数分钟。这更像一次能力上限展示,不能当作稳定率。
查看原始记录把 GIF 当视频发,模型只看到了第一帧
一个开放实验把 31.5 秒动画做成 315 帧 GIF,Vision-Exp 只识别到首帧。改为每秒 1 张、共 32 张 JPEG 后,5 个剧情问题基本答对 5/5,不过仍有角色名称错误和无法由画面证实的动作描述。
查看代码与完整结果缓存非常有用,局部识别仍要复核
同一实验用 27 张全图和 48 张局部图分析 CS2 录像。模型读对了击杀、弹药和多项 HUD 数字,却把 M4A1-S 图标认成 AWP;复用同批图片再次提问时,耗时从 71 秒降到 4.8 秒。
查看 CS2 测试记录这些记录放在一起,会得到一个不太整齐、但更接近真实工程的答案:模型名称只是变量之一。harness、提示模板、量化方式、上下文长度、缓存命中和客户端请求格式都会改写最终体验。
接入时容易踩的坑
先确认图片有没有到达 API
Maka、Cherry Studio、Qwen Code 和 DeepSeek Harness 都出现过“选了视觉模型,模型仍说看不到图”的记录。原因包括模型元数据没有声明图片能力、provider 不接受图文数组,以及客户端在发送前把 image_url 换成占位文本。排查顺序应该从最终请求体开始,而不是先怀疑模型。
高分辨率不等于高细节
单图最多 384 个视觉 token,意味着像素越多不一定读得越准。UI 截图、报表和扫描件应先裁出关键区域;需要精确数字时,再用 OCR、结构化解析或规则校验兜底。
长上下文与自托管要单独测
社区记录里既有 2×H100、256K 上下文下约 160 token/s 的顺利部署,也有本地量化后重复工具调用、parser 泄漏,以及 B300 上 1M 上下文最大并发下降的报告。这些现象很难只归因于模型,部署前需要固定硬件、推理后端、量化和 parser 版本做回归。
该选哪一个
如果系统已经能够判断输入里有没有图片,最稳妥的方案是按模态路由,而不是把所有请求都切到 Vision-Exp。
- 纯文本、代码补全优先使用 V4 Flash。路径短,也保留非思考模式下的 FIM 能力。
- 截图、图表、网页状态使用 Vision-Exp,并在业务层校验请求体确实包含图片。
- 文档小字、密集表格先裁剪或分块,再配合 OCR、坐标或结构化结果做复核。
- 长期运行的 Agent把模型、harness、parser、缓存和上下文长度作为一个整体测试。
换句话说,Vision-Exp 解决的是“让图片进入推理链”这件事。它没有取消图像压缩,也不会替代客户端适配和结果校验。对工程团队来说,这个边界比“支持多模态”五个字更重要。
资料来源与样本边界
模型结构以官方模型卡、checkpoint 配置和 API 文档为准。公开实测来自自愿发布的少量样本,存在版本、硬件和幸存者偏差;本文只把它们作为工程信号,不据此推断整体用户满意度。
展开 12 条公开使用记录
- Flash 大型代码修改与工具调用,2026-04-24
- 2×H100 本地部署与 256K 吞吐,2026-07-07
- 107 道 Aider Polyglot 子集,2026-08-04
- 17 题 SlopCodeBench,2026-08-09
- B300 上 1M 上下文并发回归,2026-08-11
- 本地量化长程工具调用问题,2026-08-20
- Vision-Exp 视频拆帧实验,2026-08-21
- Maka 视觉模型元数据缺失,2026-08-21
- 四种客户端传图对照,2026-08-22
- Cherry Studio 图片未送达模型,2026-08-22
- Qwen Code image_url 被替换,2026-08-25
- DeepSeek Harness 无法在 GUI 声明图片模态,2026-08-22